
In dit artikel
- Wat is SEO voor AI?
- Hoe heet SEO voor AI: GEO, AEO of LLMO?
- Is SEO voor AI iets anders dan gewone SEO?
- Hoe schrijf je content die AI-zoekmachines citeren?
- Wat zijn entiteiten en waarom tellen ze voor AI?
- Heb je schema nodig voor SEO voor AI?
- Moet je een llms.txt-bestand maken?
- Welke AI-crawlers moet je toelaten?
- Wat levert SEO voor AI op? Onze eigen cijfers
- Hoe meet je of AI-zoekmachines je noemen?
- Waar begin je als mkb-bedrijf?
- Veelgestelde vragen
Op 1 november 2026 werd yourtechclub.nl volgens Ahrefs in 29 AI-antwoorden genoemd. Een maand eerder waren het er 22. Ik zou dit graag brengen als bewijs dat SEO voor AI werkt. Dat kan alleen niet, want onze eigen aanpassingen gingen pas op 30 oktober live.
Daarom dit stuk, met de cijfers erbij. Eerst wat SEO voor AI is, dan wat volgens de makers van de AI-zoekmachines zelf werkt, en daarna wat we deden en hoe we meten. Een geheime knop bestaat niet. Wat je wel in handen hebt: hoe makkelijk je site te vinden, te lezen en te citeren is. En of je meet wat er gebeurt.
Wat is SEO voor AI?
SEO voor AI is het zo inrichten van je website en je naam dat AI-zoekmachines jouw informatie vinden, begrijpen en noemen in hun antwoord. Het doel verschilt van klassieke SEO: niet plek drie in een lijst met tien links, maar een vermelding in één gegenereerd antwoord. Daar staan vaak maar twee of drie bronnen in.
Een AI-zoekmachine is een dienst die een vraag beantwoordt met een zelf geschreven tekst, op basis van bronnen die hij op dat moment ophaalt. ChatGPT search, Perplexity, Copilot en de AI Overviews in Google werken zo. Hoe het taalmodel daaronder werkt, lees je bij wat een large language model is. In een lijst met links kiest de lezer zelf. In een AI-antwoord kiest de machine.
Hoe heet SEO voor AI: GEO, AEO of LLMO?
SEO voor AI heeft geen officiële naam. De meest gebruikte term is GEO, generative engine optimization. Daarnaast zie je AEO, answer engine optimization, en LLMO, large language model optimization. Ze bedoelen grotendeels hetzelfde: zorgen dat een systeem dat zelf antwoorden schrijft, jouw informatie gebruikt en jou noemt.
| Term | Voluit | Waar het op mikt |
|---|---|---|
| GEO | Generative engine optimization | Vermeld worden in antwoorden van AI-zoekmachines zoals ChatGPT search, Perplexity en AI Overviews |
| AEO | Answer engine optimization | Het directe antwoord leveren op een vraag, ook in uitgelichte fragmenten en spraakassistenten |
| LLMO | Large language model optimization | Goed vertegenwoordigd zijn in wat taalmodellen over je weten en ophalen |
| SEO voor AI | De Nederlandse verzamelnaam | Alles hierboven, plus de gewone SEO die eronder ligt |
De term GEO komt uit een wetenschappelijk artikel van november 2023, "GEO: Generative Engine Optimization" van Pranjal Aggarwal en collega's. Daarna namen marketeers hem over. Mijn advies: maak je niet druk om de naam. Wie je een apart "GEO-pakket" verkoopt dat los staat van je gewone vindbaarheid, verkoopt je meestal hetzelfde fundament twee keer.
Is SEO voor AI iets anders dan gewone SEO?
Grotendeels niet. Google schrijft letterlijk dat er geen extra eisen zijn om in AI Overviews of AI Mode te verschijnen: je pagina moet geïndexeerd zijn en met een fragment in de zoekresultaten kunnen staan. Klassieke SEO blijft dus de basis. Wat AI toevoegt, is vooral een andere manier van schrijven en meten.
De bron is helder. Op de pagina over AI-functies staat dat je geen nieuwe machineleesbare bestanden, AI-tekstbestanden of speciale schema-opmaak nodig hebt (Google Search Central, "AI features and your website", bijgewerkt 10 december 2025, geraadpleegd oktober 2026). Voor Google geldt dus: wie niet goed scoort in de gewone resultaten, scoort ook niet in de AI-antwoorden.
Wat ik níet zou doen: honderden pagina's laten genereren in de hoop dat er eentje in een AI-antwoord belandt. Dat levert dunne inhoud op, en daar houden zoekmachines en lezers allebei niet van.
Hoe schrijf je content die AI-zoekmachines citeren?
Zet het antwoord bovenaan. Schrijf onder elke kop eerst een direct antwoord van 40 tot 60 woorden en geef daarna pas de uitleg. Gebruik koppen in de vorm van een vraag, zoals mensen die aan ChatGPT stellen. Zet per sectie één zin neer die op zichzelf klopt, met een getal of een definitie.
AI-zoekmachines knippen graag een stuk tekst uit dat zonder context klopt. Dit artikel is daarom zelf ook zo opgebouwd.
Een paar vuistregels die we in onze eigen teksten aanhouden:
- Eén vraag per kop. "Wat kost een koppeling?" werkt beter dan "Kosten en overwegingen".
- Concreet in plaats van algemeen. Noem een tool, een datum, een aantal. "Binnen 5 werkdagen" zegt meer dan "snel".
- Bronnen met jaartal. Een cijfer van buiten krijgt een link en het jaar waarin het verscheen. Zo kan een lezer, en een machine, het controleren.
- Een FAQ onderaan. Korte vragen met korte antwoorden, precies in de vorm waarin mensen het aan een AI vragen.
- Een zichtbare bijwerkdatum. Bij onderwerpen die snel veranderen, wil een lezer weten of de tekst nog klopt.
Of het werkt, zie je niet altijd terug in je cijfers, want niet elke klik uit een AI-antwoord stuurt een verwijzing mee. Mijn advies: vraag bij elke nieuwe aanvraag hoe iemand je vond, en noteer het als het antwoord ChatGPT, Perplexity of een andere AI-zoekmachine is.
Wat zijn entiteiten en waarom tellen ze voor AI?
Een entiteit is voor een zoekmachine een herkenbaar ding: je bedrijf, je oprichter, je adres, je product. AI-zoekmachines koppelen informatie aan zulke entiteiten. Staat je bedrijf overal met dezelfde naam, hetzelfde adres en dezelfde omschrijving, dan weet de machine zeker dat het om jou gaat. Wisselt dat, dan twijfelt hij.
In de praktijk gaat het vaak mis op kleine dingen. Op je site heet je "Your Tech Club", op LinkedIn "YTC" en in een oude vermelding staat nog een vorig adres. Voor een mens is dat duidelijk. Een machine ziet mogelijk drie verschillende bedrijven.
Trek daarom deze gegevens gelijk op je site, je Google-bedrijfsprofiel, LinkedIn en vermeldingen op andere sites:
- Bedrijfsnaam, precies zoals je hem overal schrijft.
- Adres en vestigingsplaats.
- Namen en functies van de oprichters.
- Eén vaste zin die zegt wat je doet.
Vermeldingen buiten je eigen site tellen ook mee. Wat jij over jezelf zegt, is één bron. Wat vakmedia, brancheverenigingen of partners over je schrijven, weegt voor een AI-assistent meestal zwaarder. Links kopen hoort daar niet bij; zulke vermeldingen moet je verdienen.
Heb je schema nodig voor SEO voor AI?
Schema is een vaste manier om gegevens in je pagina te zetten, zodat machines lezen wie je bent en wat je aanbiedt. Voor Google heb je geen speciaal schema nodig om in AI Overviews te komen. Toch is het nuttig, omdat het je entiteit eenduidig beschrijft: Organization, Person, Article en FAQPage.
Sinds 30 oktober 2026 gebruiken we op onze eigen blogs drie typen. Article (precies: BlogPosting) voor de tekst zelf, met publicatie- en bijwerkdatum. Person voor de auteur, met een sameAs-link naar LinkedIn. En FAQPage voor het vragenblok onderaan. Schema moet wel kloppen met wat er op de pagina staat. Vragen in je schema die niemand op de pagina ziet, zijn een slecht idee. Zie schema dus niet als wondermiddel, maar als administratie die klopt.
Moet je een llms.txt-bestand maken?
Het kan geen kwaad, maar verwacht er niets van. Llms.txt is een voorstel uit september 2024 voor een Markdown-bestand in de hoofdmap van je site, met een korte samenvatting en links naar je belangrijkste pagina's. Het is geen officiële standaard. Of AI-zoekmachines het gebruiken bij het samenstellen van een antwoord, is niet aangetoond.
Google zegt dat je geen AI-tekstbestanden nodig hebt om in hun AI-functies te verschijnen. Van de andere grote aanbieders heb ik geen officiële bevestiging gezien dat ze llms.txt lezen. Mijn advies: maak het als je site toch al wordt bijgewerkt, het kost een uur. Besteed er geen budget aan.
Welke AI-crawlers moet je toelaten?
Kijk in je robots.txt welke crawlers je blokkeert. Voor zichtbaarheid in AI-zoekresultaten tellen vooral de zoekcrawlers, zoals OAI-SearchBot van OpenAI en Claude-SearchBot van Anthropic. Crawlers voor training, zoals GPTBot en ClaudeBot, staan daar los van. Je kunt dus training blokkeren en zoeken toelaten.
Het overzicht hieronder komt van de officiële pagina's van OpenAI, Google, Anthropic en Perplexity (geraadpleegd oktober en november 2026):
| Naam in robots.txt | Van | Waarvoor |
|---|---|---|
| OAI-SearchBot | OpenAI | Websites tonen in de zoekfuncties van ChatGPT |
| ChatGPT-User | OpenAI | Een pagina ophalen omdat een gebruiker daarom vraagt; geen automatische crawler |
| GPTBot | OpenAI | Inhoud die kan worden gebruikt om modellen te trainen |
| Google-Extended | Gebruik van inhoud voor training en grounding van Gemini; geen invloed op Google Search | |
| Claude-SearchBot | Anthropic | Inhoud indexeren voor zoekresultaten in Claude |
| ClaudeBot | Anthropic | Inhoud verzamelen die kan bijdragen aan training |
| PerplexityBot | Perplexity | Websites tonen en linken in de zoekresultaten van Perplexity; niet voor training |
Twee dingen vallen op. OpenAI zegt dat wie OAI-SearchBot blokkeert, niet in de zoekantwoorden van ChatGPT verschijnt (OpenAI, "Overview of OpenAI crawlers", geraadpleegd 1 november 2026). Een aanpassing in robots.txt is daar na ongeveer 24 uur verwerkt. En Google-Extended heeft volgens Google geen invloed op opname of ranking in Google Search.
In onze eigen robots.txt staan de crawlers van OpenAI, Anthropic, Perplexity en Google-Extended bij naam op toegestaan, samen met onder meer Bingbot en Applebot. Daar horen ook GPTBot en ClaudeBot bij. We kiezen er dus bewust voor om ook training toe te laten. Dat is een keuze, geen advies: een uitgever met betaalde artikelen kan daar heel anders over denken.
Ik kom regelmatig sites tegen waar een beveiligingsplugin of een hostingpartij alle bots met "AI" of "GPT" in de naam weert. Dan sta je dus uit voor ChatGPT search zonder dat je het weet. Bekijk ook je firewall en je CDN, want robots.txt is niet de enige plek waar een crawler strandt.
Wat levert SEO voor AI op? Onze eigen cijfers
Bij ons ging het aantal AI-vermeldingen volgens Ahrefs van 22 in oktober naar 29 op 1 november 2026. Dat is een stijging van 32 procent. Toch kan ik niet zeggen dat onze aanpassingen dat deden, want die stonden pas sinds 30 oktober live. Wat de cijfers wel laten zien: waar je staat, en welke AI-zoekmachine je mist.
| AI-zoekmachine | Oktober 2026 (nulmeting) | 1 november 2026 |
|---|---|---|
| Google AI Overviews | 13 | 14 |
| ChatGPT | 4 | 6 |
| Google AI Mode | 2 | 5 |
| Gemini | 2 | 2 |
| Copilot | 1 | 2 |
| Perplexity | 0 | 0 |
| Totaal | 22 | 29 |
Bron: eigen meting via Ahrefs (Brand Radar en Site Explorer), yourtechclub.nl, Nederland. In dezelfde periode had de site ongeveer 264 organische bezoekers per maand en een Domain Rating van 28. Een klein, gewoon mkb-domein dus.
Wat valt op? Google levert 19 van de 29 vermeldingen, als je AI Overviews en AI Mode optelt. Dat past bij wat Google zelf zegt: wie in de gewone resultaten staat, maakt kans in de AI-antwoorden. Perplexity staat op nul. Daar ga ik eerst naar kijken.
Dit is wat we op 30 oktober aan de site veranderden:
- Onder elke vraagkop staat eerst een direct antwoord.
- FAQ-, Article- en Person-schema op de blogs.
- Een reeks begrippenpagina's met korte definities.
- Een robots.txt die de AI-crawlers uit de tabel hierboven bij naam toelaat.
Sinds 25 oktober kunnen we ook IndexNow gebruiken. Dat protocol meldt nieuwe en gewijzigde pagina's direct aan zoekmachines als Bing (IndexNow FAQ, geraadpleegd november 2026). Google doet daar niet aan mee.
Hoe meet je of AI-zoekmachines je noemen?
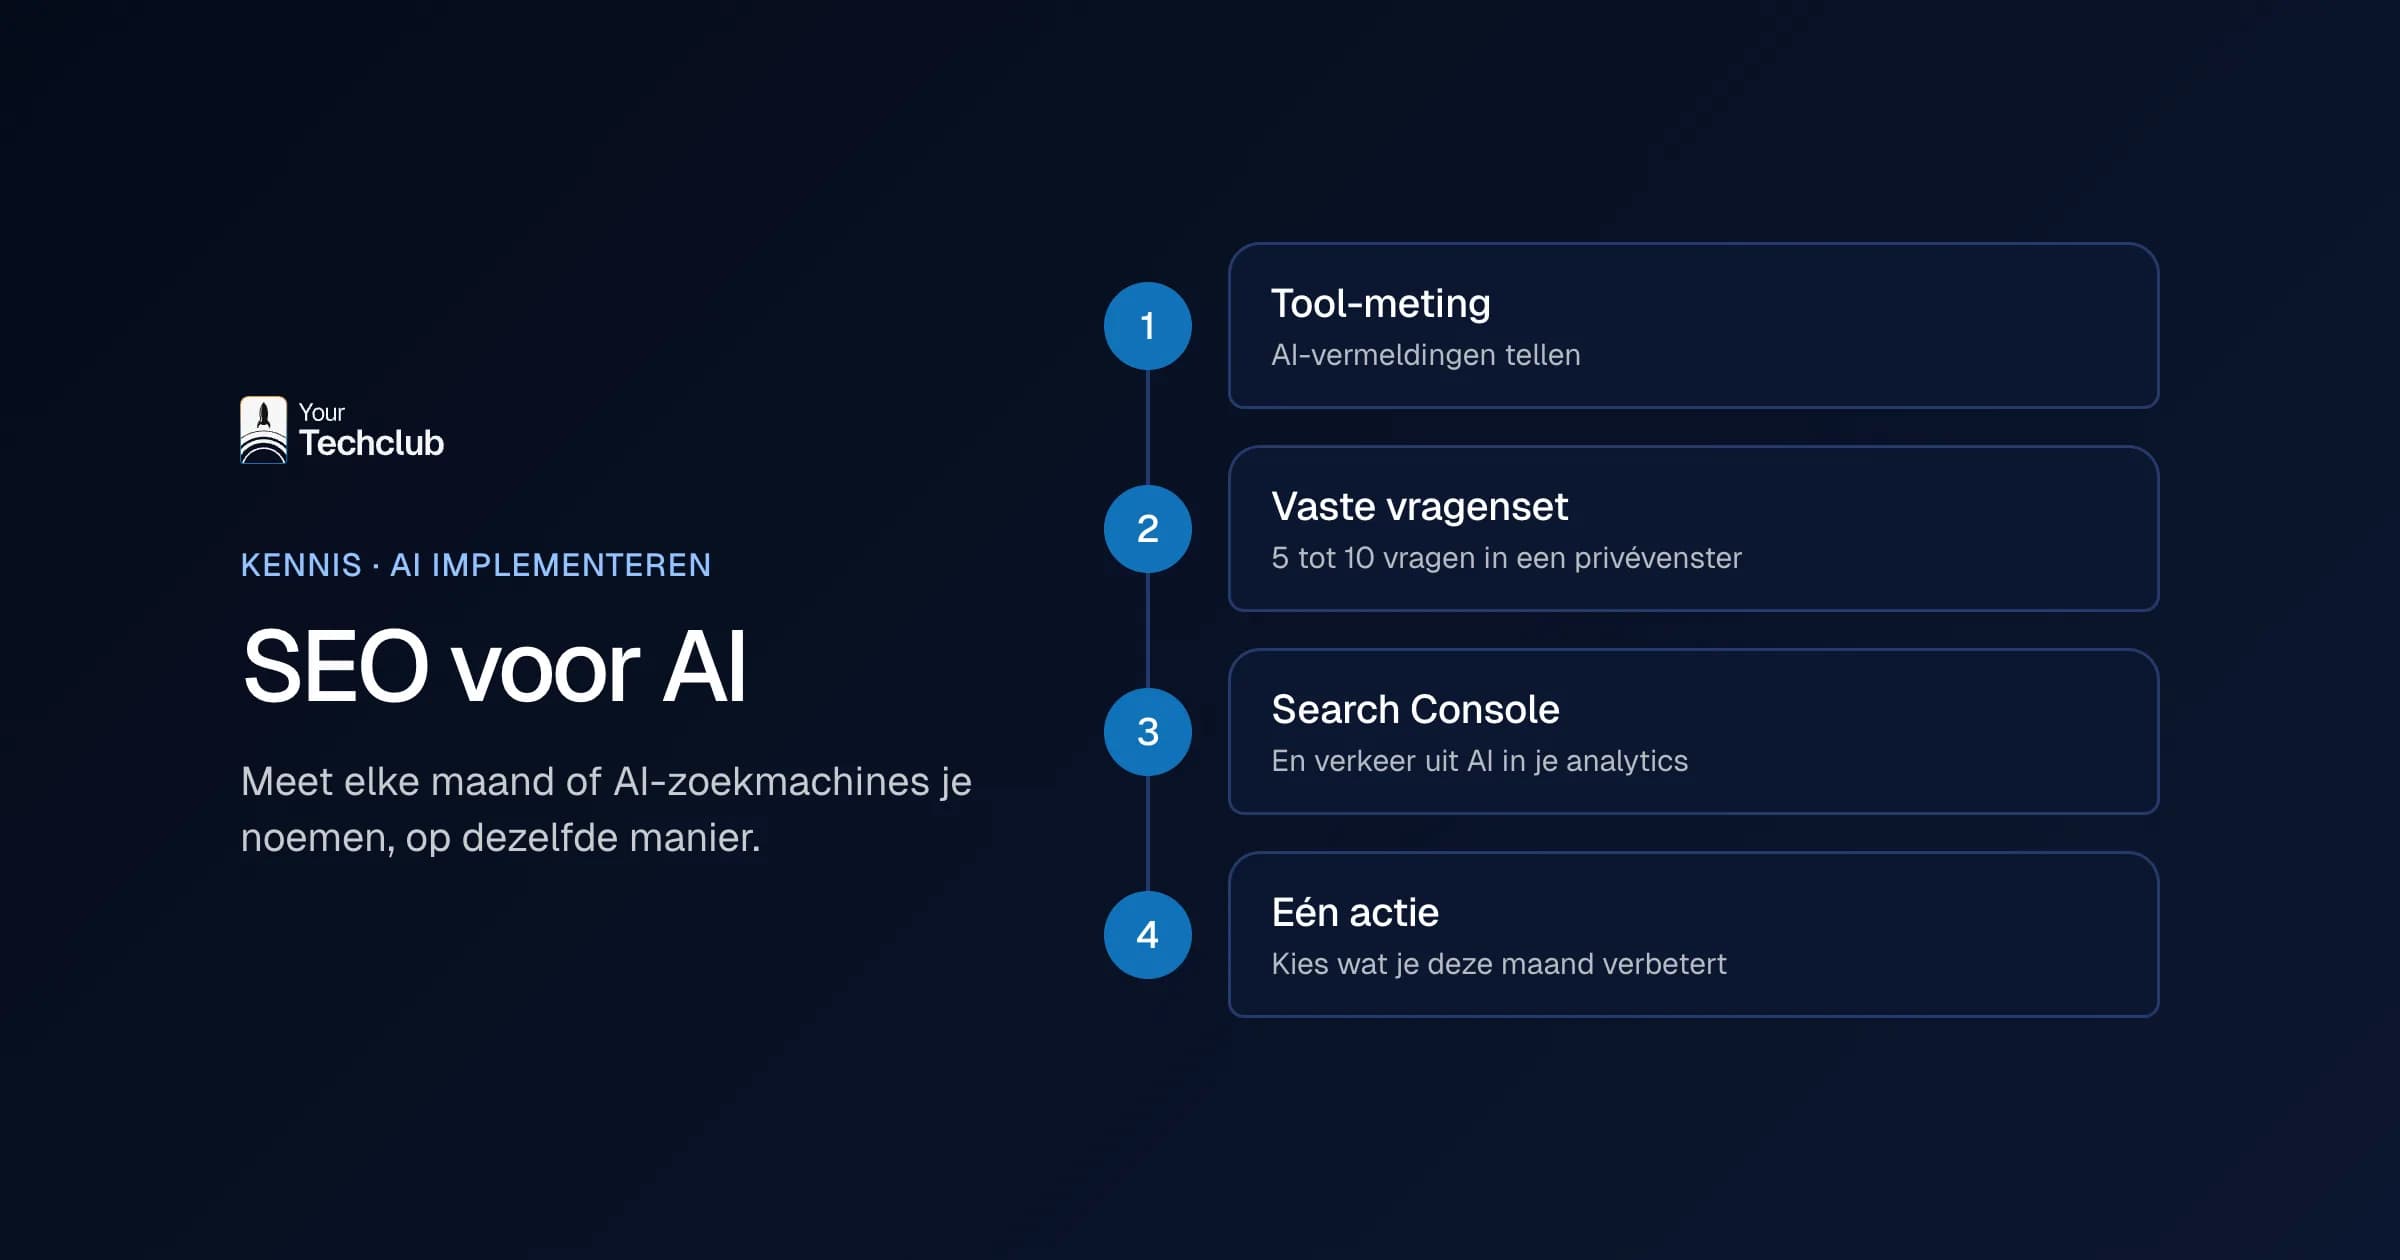
Meet elke maand op drie manieren: een tool die AI-vermeldingen telt, een vaste set vragen die je zelf aan ChatGPT, Perplexity en Google stelt, en het verkeer uit Search Console en je analytics. Eén meting zegt weinig, want AI-antwoorden wisselen per dag en per gebruiker. Na zes maanden zie je een trend.
De maandelijkse meting in vier stappen
- Eerste werkdag van de maand: tool-meting. Noteer het aantal AI-vermeldingen per AI-zoekmachine uit Ahrefs of een vergelijkbare tool. Altijd dezelfde tool, anders vergelijk je appels met peren.
- Dezelfde dag: vaste vragenset. Stel 5 tot 10 vragen die een klant zou stellen, in een privévenster en zonder ingelogd account. Noteer per vraag of je genoemd wordt, of er een link staat en wie in jouw plaats genoemd wordt.
- Search Console en analytics. Google telt klikken uit AI Overviews en AI Mode mee in het gewone prestatierapport, onder het zoektype "Web". Je ziet ze daar dus niet apart. In je analytics zie je soms chatgpt.com of perplexity.ai als verwijzer. Dat is een onderschatting, omdat niet elke klik zo'n verwijzing meestuurt.
- Eén actie kiezen. Wie wordt wel genoemd en jij niet? Kijk welke pagina van die concurrent het antwoord geeft. Dat wordt je verbeterpunt voor de komende maand.
Een spreadsheet is genoeg. Deze kolommen werken prima:
Mijn advies voor de vragenset: kies vragen die een klant echt stelt, met je dienst en je regio erin, en houd de set een paar maanden gelijk. Verander je de vragen, dan begint je meting opnieuw.
Waar begin je als mkb-bedrijf?
Begin met een nulmeting, zodat je later weet of iets werkt. Controleer daarna of je robots.txt en firewall geen AI-zoekcrawlers blokkeren en of je naam overal hetzelfde is. Herschrijf vervolgens je vijf belangrijkste pagina's met het antwoord bovenaan. Een maand later meet je opnieuw. Wij zitten nu zelf in die fase.
Een volgorde die ik zou aanhouden:
- Week 1: nulmeting met een tool en je vragenset, robots.txt en firewall nalopen.
- Week 2: naam, adres en omschrijving gelijktrekken op je site, Google-bedrijfsprofiel en LinkedIn.
- De twee weken daarna: je belangrijkste pagina's herschrijven met antwoord-eerst en een FAQ.
- Daarna: elke maand meten en per kwartaal je teksten bijwerken.
Hoort zichtbaarheid in AI bij een groter plan? Kijk dan eerst breder. In ons stappenplan om AI te implementeren in het mkb lees je hoe je bepaalt waar AI in je bedrijf echt iets oplevert. Voor bedrijven die ChatGPT zelf willen inzetten, staat er meer in ChatGPT voor bedrijven. En wie het technische onderhoud van zijn site liever uitbesteedt, kijkt bij website-onderhoud met een SLA. Hoe een technisch sterke basis eruitziet, zie je bij een headless platform dat het team zelf bijhoudt, ook via een AI-assistent.
Eerst de kans. Dan de technologie. Dat geldt voor AI in je processen, en net zo goed voor je zichtbaarheid in AI-antwoorden.
Veelgestelde vragen
Hoe heet SEO voor AI?
De meest gebruikte naam is GEO, generative engine optimization. Je ziet ook AEO (answer engine optimization) en LLMO (large language model optimization). Ze gaan allemaal over vermeld worden in antwoorden die een AI zelf schrijft.
Kun je garanderen dat ChatGPT mijn bedrijf noemt?
Nee. AI-zoekmachines kiezen zelf hun bronnen en passen hun werkwijze vaak aan. Je kunt de kans vergroten met goede SEO, heldere teksten en kloppende gegevens, en je kunt meten. Een plek in een antwoord kan niemand garanderen.
Hoe meet ik of ChatGPT mijn bedrijf noemt?
Elke maand op dezelfde manier: tel AI-vermeldingen met een tool zoals Ahrefs, stel een vaste set van 5 tot 10 vragen in een privévenster en kijk in Search Console en je analytics naar verkeer uit AI. Pas na een paar maanden zie je een trend.
Moet ik GPTBot blokkeren?
Dat is een keuze over training, niet over zichtbaarheid. GPTBot verzamelt inhoud voor het trainen van modellen. Voor de zoekfuncties van ChatGPT telt OAI-SearchBot. Je kunt GPTBot blokkeren en OAI-SearchBot toelaten.
Helpt een llms.txt-bestand om vindbaar te worden in ChatGPT?
Dat is niet aangetoond. Llms.txt is een voorstel uit 2024, geen standaard. Google zegt dat je geen AI-tekstbestanden nodig hebt. Maak het gerust, maar verwacht er geen meetbaar effect van.